article タグ: 深堀り 読了_時間: 31分
JS中心のアプローチは長期的な性能目標と両立しない Automattic のシニアパフォーマンスエンジニアがJS中心のSPA、特にReact ベースのプロジェクトが長期的な高パフォーマンス維持と構造的に相容れないことを具体的なデータで論じています。react-dom はv18 からv19 でバンドルサイズが33% 増加し、moment は5年 間で10% 肥大化しました。冗長なRedux reducer、memoisation漏れ、同期的なトップレベルimportなど、パフォーマンスを劣化させるパターンが正しい実装より遥かに手軽に陥れる構造的問題も指摘されています。ReactのDevToolsがブラウザネイティブプロファイルとの紐付けを妨げる点も解説します。緩和策(コード分割、CI上のバンドルサイズ追跡、forbidden importリント、Playwright ベースのPerfスイート)は示されているものの、維持コストが高いことも認めています。記事の締めくくりとして、クライアントサイドレンダリングをユーザーワークフローで正当化できない場合は、サーバー中心のMPA、htmx 、WordPress Interactivity API 、あるいはPreact ・Svelte ・Solid など小型フレームワークを選ぶよう業界に訴えています。
DevOps 238:43
フルスタックDockerとCI/CDを完全習得 — 本番対応パイプラインを構築 Gavin LawnがReact + Go + MongoDB で構成されたフルスタック映画ストリーミングアプリケーション「Magic Stream 」を、Docker Manager を使ってHostinger VPSにコンテナ化してデプロイする方法を解説しています。コースはまず高速パスをデモします:Docker ManagerをGitHubホストのdocker-compose.ymlのraw URLに向け、ビジュアルエディターで環境変数(OpenAI APIキー、CORS allow-origins、APIホストIP)を設定してDeployをクリックすれば、セットアップ全体が数分 で完了します。続いて、Dockerfile.prodファイルからDockerイメージをビルドしてDockerHubにプッシュするGitHub Actions ワークフローがCI/CDサイクルをトリガーする様子も示されます — Reactコンポーネントの1行 変更がgit push1回 とDocker ManagerのDeployボタンクリックだけで本番環境に反映されます。コースの後半は内部動作を詳しく解説します:Node 20-Alpine クライアント用とGo 1.24.2-Alpine サーバー用のDockerfileをレイヤーごとに記述し、docker build -tでイメージをビルド、docker run -pポートマッピングと--env-fileインジェクションで個別コンテナを起動し、最終的にdocker-compose.ymlで両サービスをまとめ、複数コマンドのワークフローをdocker compose up1つ に置き換えるまでの流れを網羅しています。
AI_インフォグラフィックopen_in_full close タグ: パフォーマンス 読了_時間: 6分
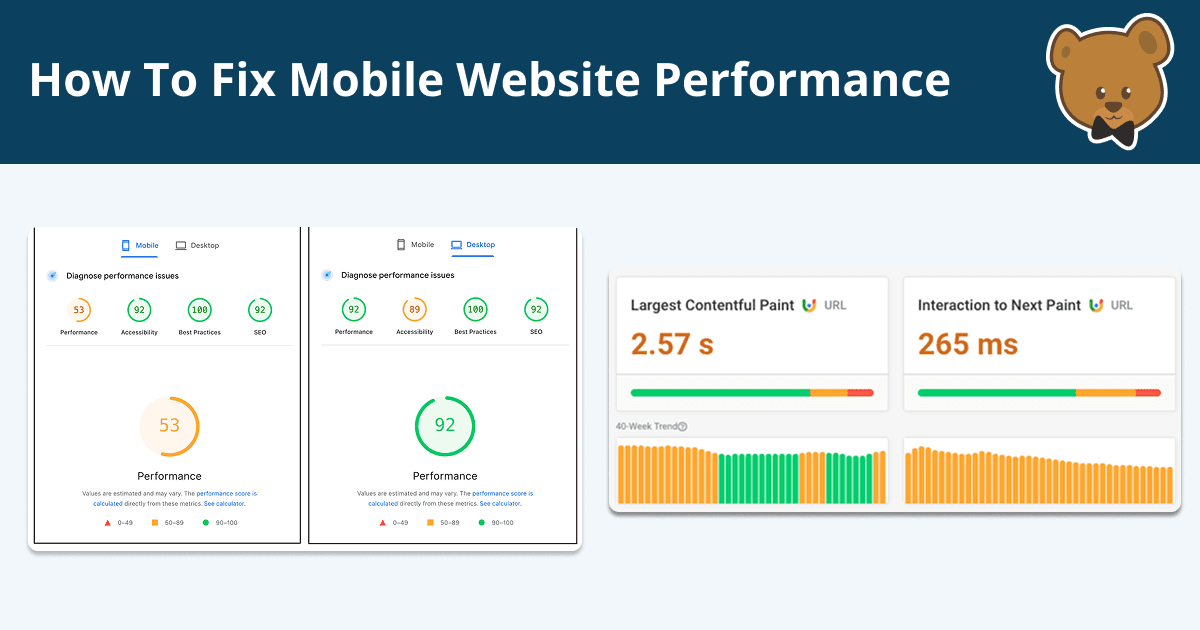
モバイル性能:Webサイトをモバイルフレンドリーにする方法 | DebugBear DebugBearのJakub AndrzejewskiはApple.comやAmazonでさえLighthouseモバイルスコアが低い(AmazonのモバイルPerformanceスコアは56 )ものの、実ユーザーのCrUXデータではCore Web Vitals評価をパスしていることを示し、ラボデータとフィールドデータを併用する必要性を解説します。5つ のコードレベルの修正が具体的に示されます:WebP形式とloading="lazy"を活用したsrcset/sizes対応レスポンシブ画像の配信、初期レンダーブロック防止のためのdefer/async適用、クリティカルCSSのインライン化とprintメディアトリックによる非クリティカルCSSの遅延読み込み、入力遅延防止のためのサードパーティウィジェットをrequestIdleCallbackでラップする手法、CLSを排除するための画像へのwidth/height属性の明示。最後にDebugBearモニターを3 G/4 G実機テストのスケジューリングとCore Web Vitalsトレンド追跡ツールとして紹介しています。
タグ: テスト 読了_時間: 12分
Playwright vs Cypress:QA自動化の究極ガイド Meghna SenがPlaywright (Microsoft、JS/TS/Python/Java/C#マルチ言語、Chromium/Firefox/WebKitネイティブ)とCypress (JS/TS専用、ブラウザ内Electronモデル、Chromeファミリー+Firefox)をアーキテクチャ、並列処理、デバッグ、エコシステム成熟度の観点から比較しています。PlaywrightはChrome DevTools Protocol 経由の外部Nodeプロセスにより並列隔離ブラウザコンテキストを標準サポートする一方、Cypressの並列化には有料クラウドインフラが必要です。Cypressのインタラクティブなtime-travelデバッガーとステップごとのコマンドログはフロントエンドの反復開発を高速化し、PlaywrightのTrace Viewer はステップごとのスクリーンショット、DOMスナップショット、ネットワークログ、タイミングデータを記録します。成熟したQAチームへの推奨パターンは階層化アプローチ:開発者側のコンポーネント高速フィードバックにCypress、CI/CDの完全リグレッションスイートにPlaywrightを使い分けるものです。両フレームワークともネイティブモバイルはサポートせず、このギャップを埋めるためにPanto QA (自然言語フローをAppium/Maestroスクリプトに変換するAI駆動のノーコードプラットフォーム)が紹介されています。
タグ: ガイド 読了_時間: 18分
数十億行を扱うVirtual Scrolling — HighTableの手法 Sylvain Lesageが、オープンソースReactコンポーネントHighTable (hyparam/hightable)でcanvas要素や擬似スクロールバーを使わずに数十億行 をレンダリングするための5つ の技術を解説しています。技法1 (lazy loading)はスクロールイベントごとに表示行インデックスを計算し、理論上1TB のデータセットを約3KB のロードに抑えます。技法2 (table slicing)は行数に関わらずDOMを約30 レンダリング行に固定し、Chromeの300 要素更新推奨値を満たします。技法3 (infinite pixels)はFirefoxの最大要素高さ(約17 Mpx)制限に対応するためcanvas divを800 万ピクセルに制限しダウンスケール係数を適用、100億行 テーブルのナビゲーションを実現します。技法4 (pixel-precise dual scroll)はマウスホイールのローカル移動とスクロールバードラッグのグローバル移動を区別し、最大2兆行 まで1 ピクセル精度を保証します。技法5 (two-step random access)はWAI Grid Pattern に基づくキーボードナビゲーションがプログラム的なscrollTop書き込みと競合しないよう、垂直・水平スクロールを分離します。
タグ: パフォーマンス 読了_時間: 14分
N+1クエリ問題を測定した。数字は想像以上に深刻 Ko-Hsin LiangがPostgreSQL 17 とPrisma 6.3.1 を使用し、100 ユーザーのデータセットで4つ のN+1 シナリオを実測しています。最も深刻なケース — 注文リストから各注文のオーナーユーザーを取得するmany-to-oneパターン — はeager loading(2 クエリ)と比べて201 クエリを発行し、22.2倍 の速度差(82.54ms → 3.72ms )を記録しました。これはネットワーク遅延がゼロのlocalhost環境での数値です。3 段階ネストフェッチ(users → posts → comments)は401 クエリを発行し、P95が185ms に達しました。1,000 ユーザーにスケールすると、ネストのbad pathは1.27秒 (4,001 クエリ)を超えました。IDをSetに集めてfindMany + WHERE INで一括取得するconditional batch-fetchパターンは56 クエリを2 クエリに削減し、データが10倍 になっても線形以下の増加に留まりました。全テストケースでデータサイズが増えるほど性能差が拡大し、「N+1 はスケール時に対処すれば良い」という通説を実証的に覆しています。
タグ: キャリア 読了_時間: 9分
遅いコードレビューの隠れたコスト:800万件のPRデータ Vitalii PerenkoがLinearB の810 万PR調査、Googleエンジニアリング研究、DORA、SmartBear、UC Irvineのデータを集約し、レビュー遅延のコストを具体的な金額で示しています。LinearBの階層分析によると、エリートチームは7時間 以内のpickupと219行 以下のPRを維持する一方、低パフォーマンスチームは50 〜137時間 以上待機し、PRサイズは395 〜793行 以上に及びます。時給$82 のフルコストと週5.8時間 の損失を基に計算すると、10人 チームは年間約$237,800 をアイドル時間で無駄にしています。SmartBearの2,500 PR 調査では、欠陥検出率は100行 未満のレビューで87% ですが、1,000行 超では28% に低下し、大きくて遅いPRは時間の浪費とバグの見逃しを同時に引き起こします。推奨アクション:PRを50行 目標に分割(Graphiteの最適値)、CODEOWNERS自動アサイン、同営業日中のpickup SLA設定、AI初回レビュー導入(所要時間2 〜3時間 →20〜30分 )、チームダッシュボードへのPRサイクルタイム表示。
summarize ダイジェスト_要約
今週の注目記事はReactのデフォルト選択への直接的な挑戦です。Automattic のシニアパフォーマンスエンジニアがreact-dom のv18 からv19 でのバンドル33% 増加やmoment の長年の肥大化などの具体的な数値を示し、JS中心のSPAが持続的な性能維持と構造的に相容れないと論じています。 この記事はReact批判ではなく、クライアントサイドレンダリングを実際のユーザーワークフローで正当化できない場合にサーバー中心のMPA・htmx ・小型フレームワークを選ぶよう促す冷静なエンジニアリング監査です。
パフォーマンスへの厳格な視点が今週のコンテンツ全体を貫いています。PostgreSQL 17 とPrisma を使った実証的なN+1 研究は、1,000 ユーザーのネストフェッチが4,001 クエリで1.27秒 を超え、データサイズが増えるほどペナルティも増大することを示し、「N+1 はスケール時に対処すれば良い」という通説を真っ向から否定します。数十億行 のデータテーブルへの仮想スクロールは、canvas要素と擬似スクロールバーを避ける5つ の技法で体系的に解説されます。モバイル性能はラボスコアと実ユーザーフィールドデータを併用する必要性を示します。
ワークフローとテストが今週を締めくくります。810 万PRのデータに基づく年間約23万7,800ドル の低速コードレビューのコスト推定は、小さなPRと当日pickup SLAのためのデータに基づいた論拠です。Playwright とCypress の比較は実用的な分業として整理されます。Docker +CI/CDの4時間 コースはDockerfileから本番デプロイまでのコンテナ化パイプライン全体を示します。
重要ポイント react-domはv18 からv19 でバンドルサイズが33% 増加しました — フルSPAアーキテクチャをデフォルト選択する前に、フレームワークの重さを実際のユーザーワークフローの複雑さと比較して測定してください。 N+1 クエリのペナルティはデータセットサイズとともに増大します。1,000 ユーザーのネストフェッチは4,001 クエリで1.27秒 を超えるため、スケール後ではなくスケール前に必ず解決する必要があります。 エリートチームはPRを219行 以下に保ち7時間 以内にpickupします。LinearBデータによると、パフォーマンスの低いチームは10人 規模で年間約23 万7,800 ドルをアイドル待機時間で無駄にしています。