이번 주 대표 기사는 React 기본값에 대한 직접적인 도전입니다. Automattic의 시니어 퍼포먼스 엔지니어가 react-dom의 v18에서 v19로의 33% 번들 증가, moment의 수년간 비대화 등 구체적인 수치를 제시하며, JS 중심 SPA가 지속적인 성능 유지와 구조적으로… 개발자가 바로 활용할 수 있도록 정리했습니다.
calendar_todaysummarize2026년 7주차
article
태그: 심층 분석읽기_시간: 31분
JS 중심 접근 방식은 장기 성능 목표와 양립할 수 없다
Automattic의 선임 퍼포먼스 엔지니어가 JS 중심 SPA, 특히 React 기반 프로젝트가 장기적으로 좋은 성능을 유지하는 데 구조적으로 부적합하다는 근거 있는 주장을 펼칩니다. react-dom은 v18에서 v19로 올리면 번들 크기가 33% 증가하고, moment는 5년 동안 10% 성장했습니다. Redux reducer 남용, memoisation 누락, 동기식 최상위 import 같은 성능 저하 패턴이 올바른 방법보다 훨씬 쉽게 적용되는 구조적 문제도 지적합니다. React의 분리된 DevTools가 프레임워크 프로파일과 브라우저 네이티브 프로파일의 연계를 방해한다는 점도 설명합니다. 완화 전략(코드 스플리팅, CI 번들 크기 검사, forbidden import linting, Playwright 기반 성능 테스트)이 제시되지만 높은 유지 비용이 따릅니다. 결론으로 서버 중심 MPA, htmx, WordPress Interactivity API 또는 Preact·Svelte·Solid 같은 소형 프레임워크를 우선 고려할 것을 촉구합니다.
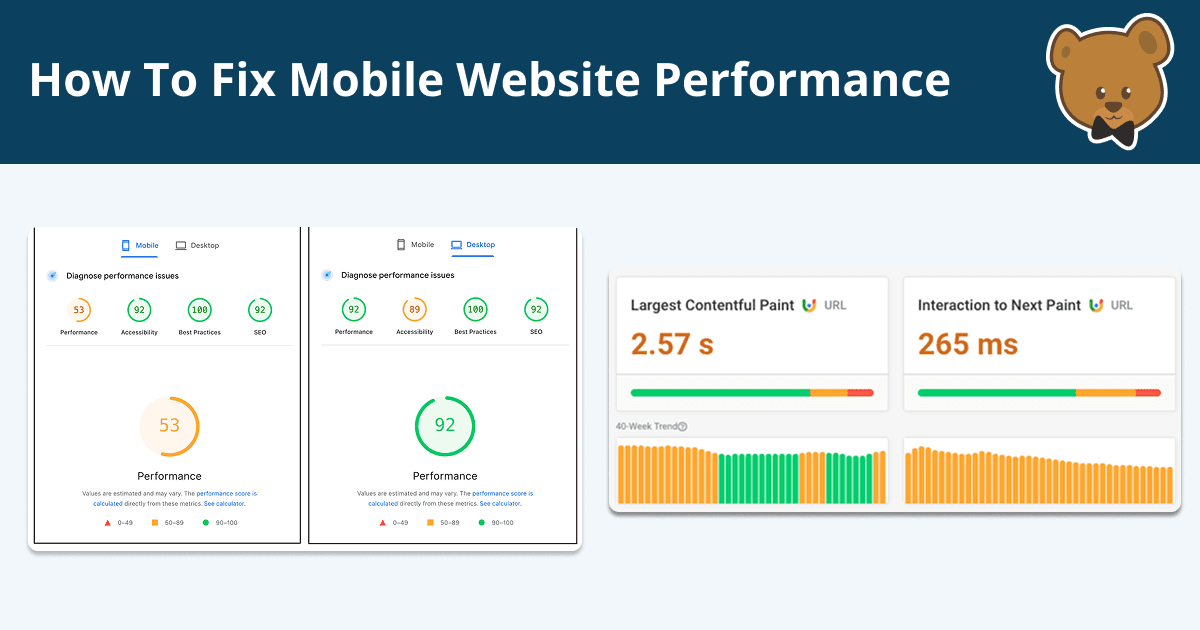
DebugBear의 Jakub Andrzejewski는 Apple.com과 Amazon조차 Lighthouse 모바일 점수가 낮지만 — Amazon의 모바일 Performance 점수는 56 — 실제 사용자 CrUX 데이터에서는 Core Web Vitals 평가를 통과한다는 점을 보여주며, 실험실 데이터와 실측 데이터를 함께 봐야 하는 이유를 설명합니다. 다섯 가지 코드 레벨 수정 사항이 구체적으로 제시됩니다: WebP 형식과 loading="lazy"를 활용한 srcset/sizes 반응형 이미지 제공, 초기 렌더 차단 방지를 위한 defer/async 적용, 인라인 크리티컬 CSS와 print 미디어 트릭을 이용한 비크리티컬 CSS 지연 로드, 입력 지연 방지를 위한 서드파티 위젯의 requestIdleCallback 래핑, CLS 제거를 위한 이미지 width/height 명시. 마지막으로 DebugBear 모니터를 3G/4G 실기기 테스트와 Core Web Vitals 추적 도구로 소개합니다.
Meghna Sen이 Playwright(Microsoft, JS/TS/Python/Java/C# 멀티언어, Chromium/Firefox/WebKit 네이티브)와 Cypress(JS/TS 전용, 브라우저 내 Electron 모델, Chrome 계열 + Firefox)를 아키텍처, 병렬 처리, 디버깅, 생태계 성숙도 측면에서 비교합니다. Playwright는 Chrome DevTools Protocol 기반 외부 Node 프로세스로 내장 병렬 격리 브라우저 컨텍스트를 지원하는 반면, Cypress는 병렬화에 유료 클라우드 인프라가 필요합니다. Cypress의 인터랙티브 time-travel 디버거와 단계별 커맨드 로그는 프런트엔드 반복 개발 속도를 높여주고, Playwright의 Trace Viewer는 단계별 스크린샷, DOM 스냅샷, 네트워크 로그, 타이밍 데이터를 캡처합니다. 성숙한 QA 팀을 위한 권장 패턴은 계층화된 접근 방식입니다: 개발자 측 컴포넌트 빠른 피드백에 Cypress, CI/CD 전체 회귀 테스트에 Playwright. 두 프레임워크 모두 네이티브 모바일을 지원하지 않으며 이 간극을 채우기 위해 Panto QA(자연어 플로우를 Appium/Maestro 스크립트로 변환하는 AI 기반 노코드 플랫폼)를 소개합니다.
Sylvain Lesage가 오픈소스 React 컴포넌트 HighTable(hyparam/hightable)에서 canvas 요소나 가짜 스크롤바 없이 수십억 개의 행을 렌더링하기 위해 사용한 다섯 가지 기법을 소개합니다. 기법 1(lazy loading)은 스크롤 이벤트마다 가시 행 인덱스를 계산해 이론상 1TB 데이터셋을 약 3KB만 로드합니다. 기법 2(table slicing)는 총 행 수와 무관하게 DOM을 약 30개의 렌더링 행으로 고정해 Chrome의 300개 요소 업데이트 권장치를 준수합니다. 기법 3(infinite pixels)은 Firefox의 최대 엘리먼트 높이(~17Mpx) 제한을 고려해 canvas div를 800만 픽셀로 제한하고 다운스케일 팩터를 적용, 100억 행 테이블 탐색을 가능하게 합니다. 기법 4(pixel-precise dual scroll)는 마우스 휠의 로컬 이동과 스크롤바 드래그의 전역 이동을 구분해 최대 2조 행까지 1픽셀 정밀도를 보장합니다. 기법 5(two-step random access)는 WAI Grid Pattern 기반 키보드 내비게이션이 프로그래밍 방식 scrollTop 쓰기와 충돌하지 않도록 수직·수평 스크롤을 분리합니다.
Ko-Hsin Liang가 PostgreSQL 17과 Prisma 6.3.1을 사용해 100명의 사용자 데이터셋으로 네 가지 N+1 시나리오를 실측합니다. 가장 심각한 경우 — 주문 목록에서 각 주문의 소유자를 조회하는 many-to-one 패턴 — 은 eager loading(2개 쿼리)과 비교해 201개 쿼리로 22.2배 느린 성능(82.54ms → 3.72ms)을 보였으며, 이는 네트워크 지연이 0인 localhost 환경입니다. 3단계 중첩 페치(users → posts → comments)는 401개 쿼리를 발생시켜 P95가 185ms에 달했습니다. 1,000명 사용자로 확장하면 중첩 bad path가 1.27초(4,001개 쿼리)를 초과했습니다. ID를 Set에 모아 findMany + WHERE IN으로 일괄 조회하는 conditional batch-fetch 패턴은 56개 쿼리를 2개로 줄였고, 데이터가 10배 증가해도 거의 선형 이하의 증가율을 보였습니다. 모든 테스트 케이스에서 데이터셋 크기가 커질수록 성능 차이가 더 벌어져, N+1은 '나중에 해결하면 되는 스케일링 문제'라는 통념을 실증적으로 반박합니다.
Vitalii Petrenko가 LinearB의 810만 PR 연구, Google 엔지니어링 연구, DORA, SmartBear, UC Irvine의 데이터를 종합해 코드 리뷰 지연의 비용을 구체적인 수치로 제시합니다. LinearB 티어링에 따르면 엘리트 팀은 7시간 이내 pickup, PR 219줄 이하를 유지하는 반면 저조한 팀은 50~137시간 이상 대기, PR 크기는 395~793줄 이상입니다. 시급 $82의 완전 비용과 주당 개발자 1인당 5.8시간 낭비를 기준으로 10인 팀은 연간 약 $237,800을 유휴 시간으로 손실합니다. SmartBear의 2,500 PR 연구에 따르면 결함 발견율은 100줄 미만 리뷰에서 87%이지만 1,000줄 초과 시 28%로 떨어져, 느리고 큰 PR은 시간 낭비와 버그 누락을 동시에 야기합니다. 권장 조치: PR을 50줄 목표로 분할(Graphite 최적값), CODEOWNERS 자동 배정, 영업일 당일 pickup SLA 설정, AI 초안 리뷰 도입(소요 시간 2~3시간 → 20~30분), 팀 대시보드에 PR 사이클 타임 노출.
Gavin Lawn이 React + Go + MongoDB로 구성된 풀스택 영화 스트리밍 애플리케이션 Magic Stream을 Docker Manager를 사용해 Hostinger VPS에 컨테이너화하고 배포하는 과정을 안내합니다. 강좌는 먼저 빠른 경로를 시연합니다: Docker Manager가 GitHub에 호스팅된 docker-compose.yml의 raw URL을 가리키도록 설정하고, 비주얼 에디터에서 환경 변수(OpenAI API 키, CORS allow-origins, API 호스트 IP)를 구성한 뒤 Deploy를 클릭하면 전체 설정이 몇 분 만에 완료됩니다. 이어서 Dockerfile.prod 파일로 Docker 이미지를 빌드해 DockerHub에 푸시하는 GitHub Actions 워크플로우가 CI/CD 사이클을 트리거하는 모습을 보여줍니다 — React 컴포넌트의 한 줄 변경이 git push 하나와 Docker Manager의 Deploy 버튼 클릭만으로 프로덕션에 반영됩니다. 강좌 후반부는 내부 동작을 깊이 다룹니다: Node 20-Alpine 클라이언트와 Go 1.24.2-Alpine 서버 각각을 위한 Dockerfile 레이어별 작성, docker build -t로 이미지 빌드, docker run -p 포트 매핑과 --env-file 주입으로 개별 컨테이너 실행, 그리고 최종적으로 docker-compose.yml로 두 서비스를 묶어 여러 명령어를 docker compose up 하나로 대체하는 과정을 포함합니다.
Automattic의 선임 퍼포먼스 엔지니어가 JS 중심 SPA, 특히 React 기반 프로젝트가 장기적으로 좋은 성능을 유지하는 데 구조적으로 부적합하다는 근거 있는 주장을 펼칩니다. react-dom은 v18에서 v19로 올리면 번들 크기가 33% 증가하고, moment는 5년 동안 10% 성장했습니다. Redux reducer 남용, memoisation 누락, 동기식 최상위 import 같은 성능 저하 패턴이 올바른 방법보다 훨씬 쉽게 적용되는 구조적 문제도 지적합니다. React의 분리된 DevTools가 프레임워크 프로파일과 브라우저 네이티브 프로파일의 연계를 방해한다는 점도 설명합니다. 완화 전략(코드 스플리팅, CI 번들 크기 검사, forbidden import linting, Playwright 기반 성능 테스트)이 제시되지만 높은 유지 비용이 따릅니다. 결론으로 서버 중심 MPA, htmx, WordPress Interactivity API 또는 Preact·Svelte·Solid 같은 소형 프레임워크를 우선 고려할 것을 촉구합니다.
Gavin Lawn이 React + Go + MongoDB로 구성된 풀스택 영화 스트리밍 애플리케이션 Magic Stream을 Docker Manager를 사용해 Hostinger VPS에 컨테이너화하고 배포하는 과정을 안내합니다. 강좌는 먼저 빠른 경로를 시연합니다: Docker Manager가 GitHub에 호스팅된 docker-compose.yml의 raw URL을 가리키도록 설정하고, 비주얼 에디터에서 환경 변수(OpenAI API 키, CORS allow-origins, API 호스트 IP)를 구성한 뒤 Deploy를 클릭하면 전체 설정이 몇 분 만에 완료됩니다. 이어서 Dockerfile.prod 파일로 Docker 이미지를 빌드해 DockerHub에 푸시하는 GitHub Actions 워크플로우가 CI/CD 사이클을 트리거하는 모습을 보여줍니다 — React 컴포넌트의 한 줄 변경이 git push 하나와 Docker Manager의 Deploy 버튼 클릭만으로 프로덕션에 반영됩니다. 강좌 후반부는 내부 동작을 깊이 다룹니다: Node 20-Alpine 클라이언트와 Go 1.24.2-Alpine 서버 각각을 위한 Dockerfile 레이어별 작성, docker build -t로 이미지 빌드, docker run -p 포트 매핑과 --env-file 주입으로 개별 컨테이너 실행, 그리고 최종적으로 docker-compose.yml로 두 서비스를 묶어 여러 명령어를 docker compose up 하나로 대체하는 과정을 포함합니다.
DebugBear의 Jakub Andrzejewski는 Apple.com과 Amazon조차 Lighthouse 모바일 점수가 낮지만 — Amazon의 모바일 Performance 점수는 56 — 실제 사용자 CrUX 데이터에서는 Core Web Vitals 평가를 통과한다는 점을 보여주며, 실험실 데이터와 실측 데이터를 함께 봐야 하는 이유를 설명합니다. 다섯 가지 코드 레벨 수정 사항이 구체적으로 제시됩니다: WebP 형식과 loading="lazy"를 활용한 srcset/sizes 반응형 이미지 제공, 초기 렌더 차단 방지를 위한 defer/async 적용, 인라인 크리티컬 CSS와 print 미디어 트릭을 이용한 비크리티컬 CSS 지연 로드, 입력 지연 방지를 위한 서드파티 위젯의 requestIdleCallback 래핑, CLS 제거를 위한 이미지 width/height 명시. 마지막으로 DebugBear 모니터를 3G/4G 실기기 테스트와 Core Web Vitals 추적 도구로 소개합니다.
Meghna Sen이 Playwright(Microsoft, JS/TS/Python/Java/C# 멀티언어, Chromium/Firefox/WebKit 네이티브)와 Cypress(JS/TS 전용, 브라우저 내 Electron 모델, Chrome 계열 + Firefox)를 아키텍처, 병렬 처리, 디버깅, 생태계 성숙도 측면에서 비교합니다. Playwright는 Chrome DevTools Protocol 기반 외부 Node 프로세스로 내장 병렬 격리 브라우저 컨텍스트를 지원하는 반면, Cypress는 병렬화에 유료 클라우드 인프라가 필요합니다. Cypress의 인터랙티브 time-travel 디버거와 단계별 커맨드 로그는 프런트엔드 반복 개발 속도를 높여주고, Playwright의 Trace Viewer는 단계별 스크린샷, DOM 스냅샷, 네트워크 로그, 타이밍 데이터를 캡처합니다. 성숙한 QA 팀을 위한 권장 패턴은 계층화된 접근 방식입니다: 개발자 측 컴포넌트 빠른 피드백에 Cypress, CI/CD 전체 회귀 테스트에 Playwright. 두 프레임워크 모두 네이티브 모바일을 지원하지 않으며 이 간극을 채우기 위해 Panto QA(자연어 플로우를 Appium/Maestro 스크립트로 변환하는 AI 기반 노코드 플랫폼)를 소개합니다.
Sylvain Lesage가 오픈소스 React 컴포넌트 HighTable(hyparam/hightable)에서 canvas 요소나 가짜 스크롤바 없이 수십억 개의 행을 렌더링하기 위해 사용한 다섯 가지 기법을 소개합니다. 기법 1(lazy loading)은 스크롤 이벤트마다 가시 행 인덱스를 계산해 이론상 1TB 데이터셋을 약 3KB만 로드합니다. 기법 2(table slicing)는 총 행 수와 무관하게 DOM을 약 30개의 렌더링 행으로 고정해 Chrome의 300개 요소 업데이트 권장치를 준수합니다. 기법 3(infinite pixels)은 Firefox의 최대 엘리먼트 높이(~17Mpx) 제한을 고려해 canvas div를 800만 픽셀로 제한하고 다운스케일 팩터를 적용, 100억 행 테이블 탐색을 가능하게 합니다. 기법 4(pixel-precise dual scroll)는 마우스 휠의 로컬 이동과 스크롤바 드래그의 전역 이동을 구분해 최대 2조 행까지 1픽셀 정밀도를 보장합니다. 기법 5(two-step random access)는 WAI Grid Pattern 기반 키보드 내비게이션이 프로그래밍 방식 scrollTop 쓰기와 충돌하지 않도록 수직·수평 스크롤을 분리합니다.
Ko-Hsin Liang가 PostgreSQL 17과 Prisma 6.3.1을 사용해 100명의 사용자 데이터셋으로 네 가지 N+1 시나리오를 실측합니다. 가장 심각한 경우 — 주문 목록에서 각 주문의 소유자를 조회하는 many-to-one 패턴 — 은 eager loading(2개 쿼리)과 비교해 201개 쿼리로 22.2배 느린 성능(82.54ms → 3.72ms)을 보였으며, 이는 네트워크 지연이 0인 localhost 환경입니다. 3단계 중첩 페치(users → posts → comments)는 401개 쿼리를 발생시켜 P95가 185ms에 달했습니다. 1,000명 사용자로 확장하면 중첩 bad path가 1.27초(4,001개 쿼리)를 초과했습니다. ID를 Set에 모아 findMany + WHERE IN으로 일괄 조회하는 conditional batch-fetch 패턴은 56개 쿼리를 2개로 줄였고, 데이터가 10배 증가해도 거의 선형 이하의 증가율을 보였습니다. 모든 테스트 케이스에서 데이터셋 크기가 커질수록 성능 차이가 더 벌어져, N+1은 '나중에 해결하면 되는 스케일링 문제'라는 통념을 실증적으로 반박합니다.
Vitalii Petrenko가 LinearB의 810만 PR 연구, Google 엔지니어링 연구, DORA, SmartBear, UC Irvine의 데이터를 종합해 코드 리뷰 지연의 비용을 구체적인 수치로 제시합니다. LinearB 티어링에 따르면 엘리트 팀은 7시간 이내 pickup, PR 219줄 이하를 유지하는 반면 저조한 팀은 50~137시간 이상 대기, PR 크기는 395~793줄 이상입니다. 시급 $82의 완전 비용과 주당 개발자 1인당 5.8시간 낭비를 기준으로 10인 팀은 연간 약 $237,800을 유휴 시간으로 손실합니다. SmartBear의 2,500 PR 연구에 따르면 결함 발견율은 100줄 미만 리뷰에서 87%이지만 1,000줄 초과 시 28%로 떨어져, 느리고 큰 PR은 시간 낭비와 버그 누락을 동시에 야기합니다. 권장 조치: PR을 50줄 목표로 분할(Graphite 최적값), CODEOWNERS 자동 배정, 영업일 당일 pickup SLA 설정, AI 초안 리뷰 도입(소요 시간 2~3시간 → 20~30분), 팀 대시보드에 PR 사이클 타임 노출.
이번 주 대표 기사는 React 기본값에 대한 직접적인 도전입니다. Automattic의 시니어 퍼포먼스 엔지니어가 react-dom의 v18에서 v19로의 33% 번들 증가, moment의 수년간 비대화 등 구체적인 수치를 제시하며, JS 중심 SPA가 지속적인 성능 유지와 구조적으로 양립할 수 없다고 주장합니다. 이 글은 React 반대 논쟁이 아니라, 실제 사용자 워크플로우로 클라이언트 사이드 렌더링을 정당화할 수 없을 때 서버 중심 MPA, htmx, 또는 소형 프레임워크를 선택하도록 권고하는 냉철한 엔지니어링 감사입니다.
퍼포먼스에 대한 엄밀한 시각이 이번 주 내용 전반에 흐릅니다. PostgreSQL 17과 Prisma를 활용한 실증적 N+1 연구는 1,000명 사용자 기준 순진한 중첩 페치가 4,001개 쿼리로 1.27초를 넘기며, 데이터셋 크기가 커질수록 페널티도 커져 N+1이 '나중에 해결할 스케일링 문제'라는 통념을 정면으로 반박합니다. 수십억 행 데이터 테이블의 가상 스크롤은 canvas 요소와 가짜 스크롤바를 피하는 다섯 가지 기법으로 체계적으로 다뤄집니다. 모바일 성능은 실험실 점수와 실제 사용자 필드 데이터를 함께 읽어야 하는 이유를 보여줍니다.
워크플로우와 테스팅이 이번 주를 마무리합니다. 810만 PR 데이터 기반으로 도출된 연간 약 23만 7,800달러의 느린 코드 리뷰 비용 추정은 소규모 PR과 당일 pickup SLA를 위한 데이터 중심 논거입니다. Playwright 대 Cypress 비교는 실용적인 분업으로 정리됩니다. Docker와 CI/CD 4시간 강좌는 Dockerfile부터 프로덕션 배포까지 전체 컨테이너화 파이프라인을 보여줍니다.
핵심 요점
react-dom은 v18에서 v19로 번들 크기가 33% 증가하였으므로, 전체 SPA 아키텍처를 기본값으로 선택하기 전에 프레임워크의 무게를 실제 사용자 워크플로우 복잡성과 비교하여 측정하십시오.
N+1 쿼리 패널티는 데이터셋 크기에 따라 줄어드는 것이 아니라 커집니다. 1,000명 사용자의 중첩 페치는 4,001개 쿼리로 1.27초를 초과하므로, 스케일링 이후가 아닌 이전에 반드시 해결해야 합니다.
엘리트 팀은 PR을 219줄 이하로 유지하고 7시간 이내에 pickup합니다. LinearB 데이터에 따르면 저조한 팀은 10인 기준 연간 약 23만 7,800달러를 유휴 대기 시간으로 낭비합니다.